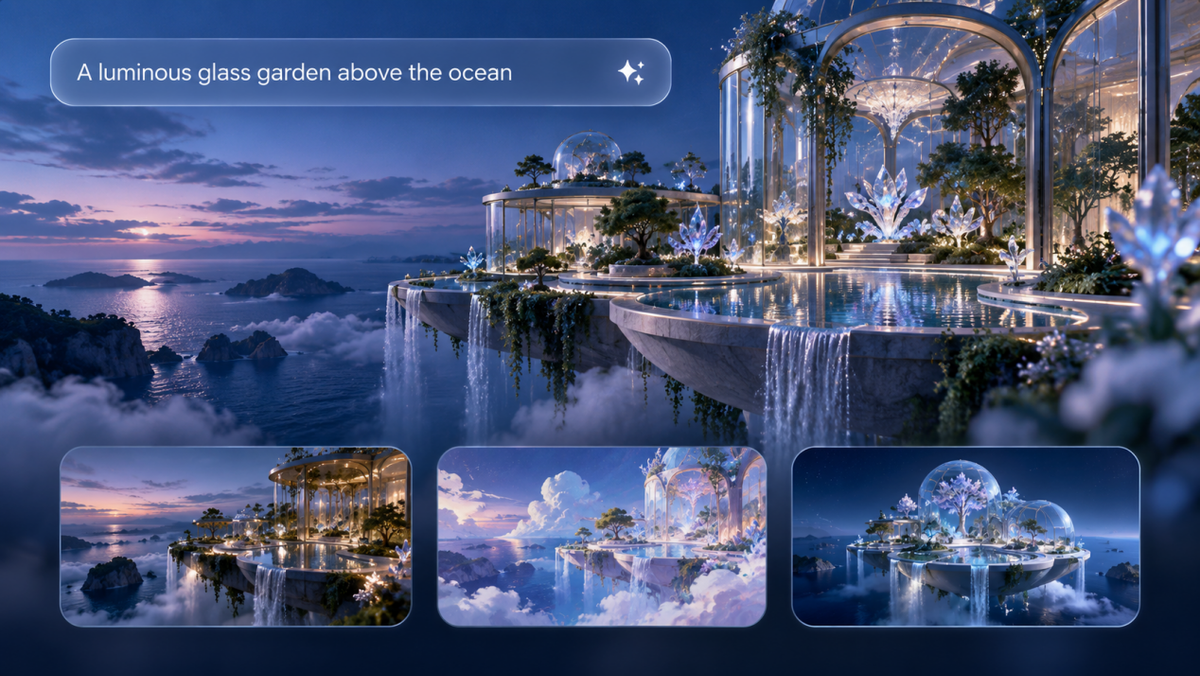
Con una semplice idea o una breve descrizione, i modelli text-to-image possono trasformare il linguaggio naturale in concetti visivi. Per i creatori, i migliori modelli text-to-image vanno oltre la semplice generazione di immagini. Devono comprendere prompt complessi, preservare la coerenza visiva e supportare un raffinamento creativo nel tempo. Questa guida spiega come funzionano i modelli text-to-image, confronta le funzionalità che contano di più ed esplora come Kling IMAGE 3.0 combini creazione basata su riferimenti, editing preciso e flussi di lavoro flessibili per aiutare i creatori a dare vita alle loro idee visive.
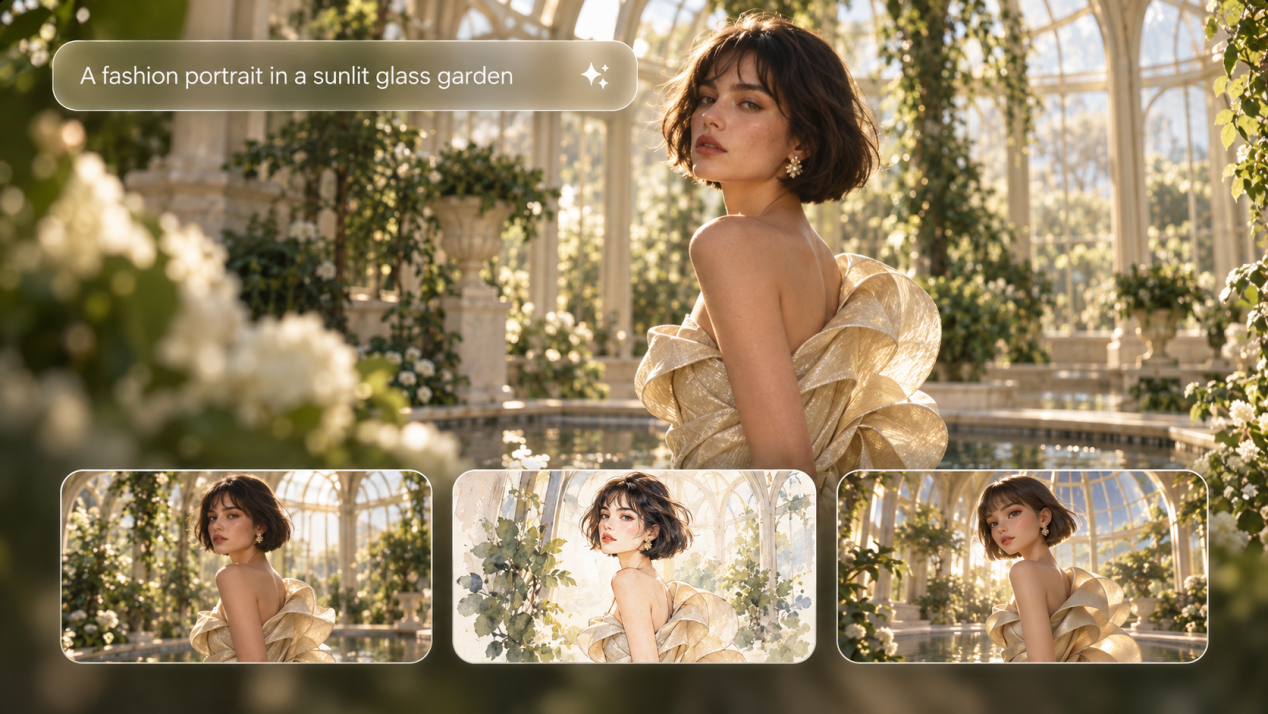
Cosa sono i modelli text-to-image?
Un modello text-to-image è un tipo di sistema di intelligenza artificiale che converte prompt in linguaggio naturale in immagini digitali basate sui dettagli descritti nel prompt.
I moderni sistemi text-to-image generalmente combinano una componente che comprende o codifica il prompt con una componente di generazione di immagini che trasforma tali istruzioni in contenuti visivi. Alcuni modelli possono anche lavorare con immagini e altri riferimenti visivi, aiutandoli a seguire prompt complessi, a preservare dettagli importanti e a supportare modifiche più precise.
Per esempio, consideriamo un prompt:
| Prompt: Una fotocamera vintage appoggiata su una scrivania di legno con una morbida luce mattutina che cade sulla scena. |
Il modello deve comprendere l'oggetto, il materiale, la disposizione spaziale, l'illuminazione e lo stile visivo complessivo prima di produrre l'immagine corrispondente.
Oggi, valutare i modelli text-to-image riguarda più della sola qualità dell'immagine. L'attenzione si è spostata verso una comprensione accurata del prompt, la gestione di scene complesse, il mantenimento della coerenza visiva e il supporto per modifiche flessibili.
Come funzionano i modelli text-to-image?
I modelli text-to-image traducono le descrizioni scritte in contenuti visivi imparando come il linguaggio si relaziona agli oggetti, agli stili, alle composizioni e ad altri dettagli. Molti sistemi moderni utilizzano metodi basati sulla diffusione, con il prompt che guida un processo graduale passo dopo passo che trasforma gradualmente il rumore visivo in un'immagine finita.
Il processo può essere compreso in tre fasi:
1.Imparare come il testo si collega alle immagini
Prima di generare immagini, un modello text-to-image apprende da ampi dataset contenenti immagini abbinate a descrizioni. Durante l'addestramento, identifica schemi tra parole e dettagli visivi, inclusi oggetti, colori, forme, stili e relazioni spaziali. Ad esempio, il modello apprende come concetti quali "fotocamera vintage", "scrivania di legno" e "luce morbida del mattino" siano associati a specifiche caratteristiche visive.
2.Comprendere il prompt
Quando inserisci un prompt, il sistema traduce il tuo testo in un formato che può comprendere, catturandone il significato e il contesto principali. Sebbene la tecnologia esatta vari da modello a modello—e i sistemi commerciali spesso mantengano nascosta la loro architettura completa—queste componenti testuali e visive collaborano per mettere in relazione le tue parole con il risultato visivo finale.
3.Generazione dell'immagine
Molti modelli moderni text-to-image utilizzano metodi di diffusione, sebbene altri possano adottare approcci autoregressivi o differenti modalità di generazione. Nei sistemi basati sulla diffusione, il processo inizia con rumore visivo e rimuove gradualmente tale rumore in base alle informazioni fornite dal prompt. Attraverso ripetuti passaggi di denoising, l'immagine sviluppa forme, dettagli e stili più definiti che corrispondono alla descrizione. Alcuni sistemi eseguono questo processo in uno spazio latente compresso prima di convertire il risultato nell'immagine finale. Una volta formata l'immagine, si possono effettuare ulteriori regolazioni per affinare i dettagli o prepararla all'editing.
Cosa rende diversi i modelli text-to-image?
I modelli text-to-image possono rispondere in modo molto diverso allo stesso prompt. In parte ciò dipende dal modo in cui vengono generate le immagini, mentre in parte dipende dai tipi di input che il modello può leggere e utilizzare.
Architettura di generazione
A livello della generazione, due approcci comuni sono la diffusione e la generazione autoregressiva.
Approccio | Come funziona | Usi comuni |
Modelli di diffusione | Inizia con del rumore visivo e lo affina gradualmente in un'immagine guidata dal prompt. | Generazione di immagini dettagliate, scene realistiche, illustrazione e lavori guidati dallo stile. |
Modelli autoregressivi | Costruisci un'immagine prevedendo in sequenza token o elementi visivi. | Generazione di immagini che costruisce contenuti visivi in sequenza invece di affinare il rumore. |
I modelli di diffusione restano un'area attiva di ricerca text-to-image. L'indagine del 2023 Text-to-image Diffusion Models in Generative AI: A Survey offre una panoramica utile dei metodi text-to-image basati sulla diffusione, dei dataset, degli approcci di valutazione e delle applicazioni correlate.
Input multimodali
Multimodale descrive i tipi di input che un modello può utilizzare piuttosto che il modo in cui genera un'immagine. Un modello di immagini multimodale può accettare testo, immagini e riferimenti visivi per la creazione basata su riferimenti, l'editing o il mantenimento della coerenza di personaggi e prodotti in una serie. Alla base può comunque usare la diffusione, la generazione autoregressiva o un altro metodo, quindi un modello può rientrare in più di una categoria.
Quali sono i migliori modelli text-to-image nel 2026?
Per questa guida, abbiamo selezionato sette modelli attuali che rappresentano diversi approcci alla generazione di immagini, all'editing, alla creazione basata su riferimenti e alla produzione visiva. L'ordine non è una classifica.
Modello | Tipo di modello | Ideale per | Caratteristiche principali |
Modello di generazione e modifica di immagini con input multimodali | Creazione basata su riferimenti, visuali di prodotto, personaggi e modifiche dettagliate | Genera da testo o immagini, combina caratteristiche provenienti da fino a 10 riferimenti e supporta la conservazione del soggetto, modifiche precise e controllo dello stile. IMAGE 3.0 supporta la generazione fino a 2K, mentre IMAGE 3.0 Omni offre fino a 4K. | |
Leonardo Lucid Origin | Modello di generazione di immagini | Illustrazione, concept art, mockup di prodotto e creazione di immagini generali | Copre un'ampia gamma di stili, segue prompt dettagliati, produce immagini Full HD e supporta il rendering di testo leggibile. |
Seedream 5.0 Pro | Modello di generazione e modifica di immagini | Immagini di prodotto, infografiche, risorse di design e modifiche locali | Funziona a partire da testi o immagini, accetta riferimenti, supporta la modifica regionale e gestisce l'input e la generazione multilingue. |
Adobe Firefly Image 5 | Modello di generazione e modifica di immagini | Produzione di design, asset di marketing e progetti basati su Adobe | Genera a partire da testo, funziona con immagini di riferimento e consente modifiche mirate in Photoshop lasciando intatto il contenuto dell'immagine circostante. |
Krea 2 Large | Modello di generazione di immagini | Fotorealismo, lavori guidati dallo stile e direzione visiva | Ottimizzato per un fotorealismo espressivo, con creazione basata su prompt e controllo guidato da riferimenti su composizione, soggetto e stile. |
Luma UNI-1.1 | Modello di immagine multimodale unificato | Generazione guidata da riferimenti e revisione dell'immagine | Combina la generazione di immagini con l'editing in linguaggio naturale e accetta fino a nove input di riferimento in una richiesta. |
Runway Gen-4 Image | Modello di generazione di immagini all'interno di una piattaforma di immagini e video | Sviluppo dei personaggi, progettazione delle scene e progetti che in seguito passano al video | Genera da testo e immagini di riferimento, utilizza fino a tre riferimenti per generazione e può trasportare personaggi, oggetti o tratti visivi in nuove scene. |
La sezione successiva confronta questi modelli in termini di aderenza al prompt, gestione dei riferimenti, modifica, coerenza visiva e controllo dello stile.
Come si confrontano i modelli text-to-image nel 2026?
I modelli text-to-image differiscono soprattutto nella precisione del prompt, nell'uso dei riferimenti, nella modifica, nella coerenza e nel controllo dello stile. Queste differenze sono più facili da notare in progetti che coinvolgono immagini ripetute, revisioni, prodotti o personaggi ricorrenti.
Area di confronto | Cosa confrontare | Perché è importante |
Rispetto del prompt | Soggetti, attributi, relazioni tra oggetti, composizione e dettagli richiesti. | Un'immagine curata risulta comunque insufficiente se non risponde al brief. |
Gestione dei riferimenti | Numero di riferimenti, mantenimento del soggetto, trasferimento dello stile e guida alla composizione. | I riferimenti aiutano a mantenere riconoscibili un personaggio, un prodotto o una direzione visiva tra le immagini. |
Modifica delle immagini | Modifiche locali, interventi in linguaggio naturale e quanto bene le aree non toccate rimangono intatte. | Le modifiche precise fanno risparmiare tempo ed evitano di ricostruire l'immagine da zero. |
Coerenza visiva | Personaggi, prodotti, abbigliamento, stile e dettagli ricorrenti tra immagini o revisioni. | I dettagli stabili sono importanti per serie di immagini, campagne, storyboard e set di prodotti. |
Controllo dello stile | Illuminazione, palette, texture, look fotografico, stile illustrativo e direzione visiva. | Un controllo chiaro dello stile aiuta a mantenere le immagini correlate visivamente collegate. |
Adattamento del flusso di lavoro | Revisioni, opzioni di esportazione, uso di funzionalità da immagine a video e compatibilità con altri strumenti creativi. | Ciò che accade dopo la generazione può essere importante quanto la prima immagine. |
Un modello che funziona bene per immagini concettuali rapide potrebbe non adattarsi a una serie di prodotti o a un progetto su un personaggio. L'accuratezza del prompt e lo stile possono essere sufficienti per una singola immagine, mentre il lavoro ripetuto richiede spesso riferimenti più solidi, editing e coerenza.
Come scegliere il miglior modello da testo a immagine?
Quando scegli un Generatore di immagini AI, inizia da ciò che vuoi creare e quali dettagli devono rimanere invariati mentre modifichi l'immagine. La tabella seguente mostra cosa considerare in diversi scenari comuni.
Se hai bisogno | Cerca | Perché è importante |
Immagini concettuali rapide | Precisione del prompt, qualità dell'immagine e gamma di stili | Puoi avvicinarti di più al risultato desiderato con meno revisioni. |
Personaggi o prodotti coerenti | Gestione dei riferimenti e conservazione dei dettagli | Volti, abbigliamento, prodotti e altre caratteristiche distintive devono restare riconoscibili tra le immagini. |
Revisioni frequenti delle immagini | Modifiche locali e cambiamenti in linguaggio naturale | Puoi modificare una parte dell'immagine senza ricostruire l'intera scena. |
Risorse di campagna o serie di immagini | Soggetti stabili, stile e composizione | Le immagini correlate devono condividere la stessa direzione visiva. |
Immagini che in seguito si trasformano in video | Immagini di riferimento e opzioni da immagine a video | I soggetti stabili e i dettagli visivi sono più facili da portare nel movimento. |
Perché vale la pena prendere in considerazione Kling IMAGE 3.0?
Kling IMAGE 3.0 ti permette di avviare creazioni con un prompt testuale o immagini di riferimento, quindi di rifinire ogni dettaglio usando il linguaggio naturale. Oltre alla generazione standard, ti offre un controllo profondo sulla coerenza dei personaggi, modifiche precise e ottimizzazione dello stile, aprendo infinite possibilità creative.
Trasforma idee complesse in nuove immagini
IMAGE 3.0 ti consente di fondere indizi visivi da più riferimenti e di usare il linguaggio quotidiano per andare oltre le modifiche standard. Combina soggetti presenti in immagini diverse, capovolgi la prospettiva di una scena o trasforma un concetto in uno stile completamente nuovo, mantenendo al contempo il risultato finale fluido e coerente.
Immagine di riferimento 1 | Immagine di riferimento 2 | Immagine risultante |
Prompt: Unisci gli animali dell'immagine 1 e dell'immagine 2. | ||
Mantieni personaggi, prodotti e dettagli chiave riconoscibili
Puoi utilizzare fino a 10 immagini di riferimento in una singola generazione. Riferimenti diversi possono definire un personaggio, un abbigliamento, un prodotto, un'ambientazione o uno stile mentre il tuo prompt spiega come quegli elementi dovrebbero combinarsi. Per i ritocchi dei ritratti, i riferimenti del volto possono aiutare a preservare i tratti facciali riconoscibili mentre cambi l'acconciatura, l'abito, la posa o l'ambientazione. Se vuoi solo sostituire un volto in uno scatto esistente, puoi anche passare direttamente ai workflow face swap di Kling.
Cambia solo ciò che deve cambiare
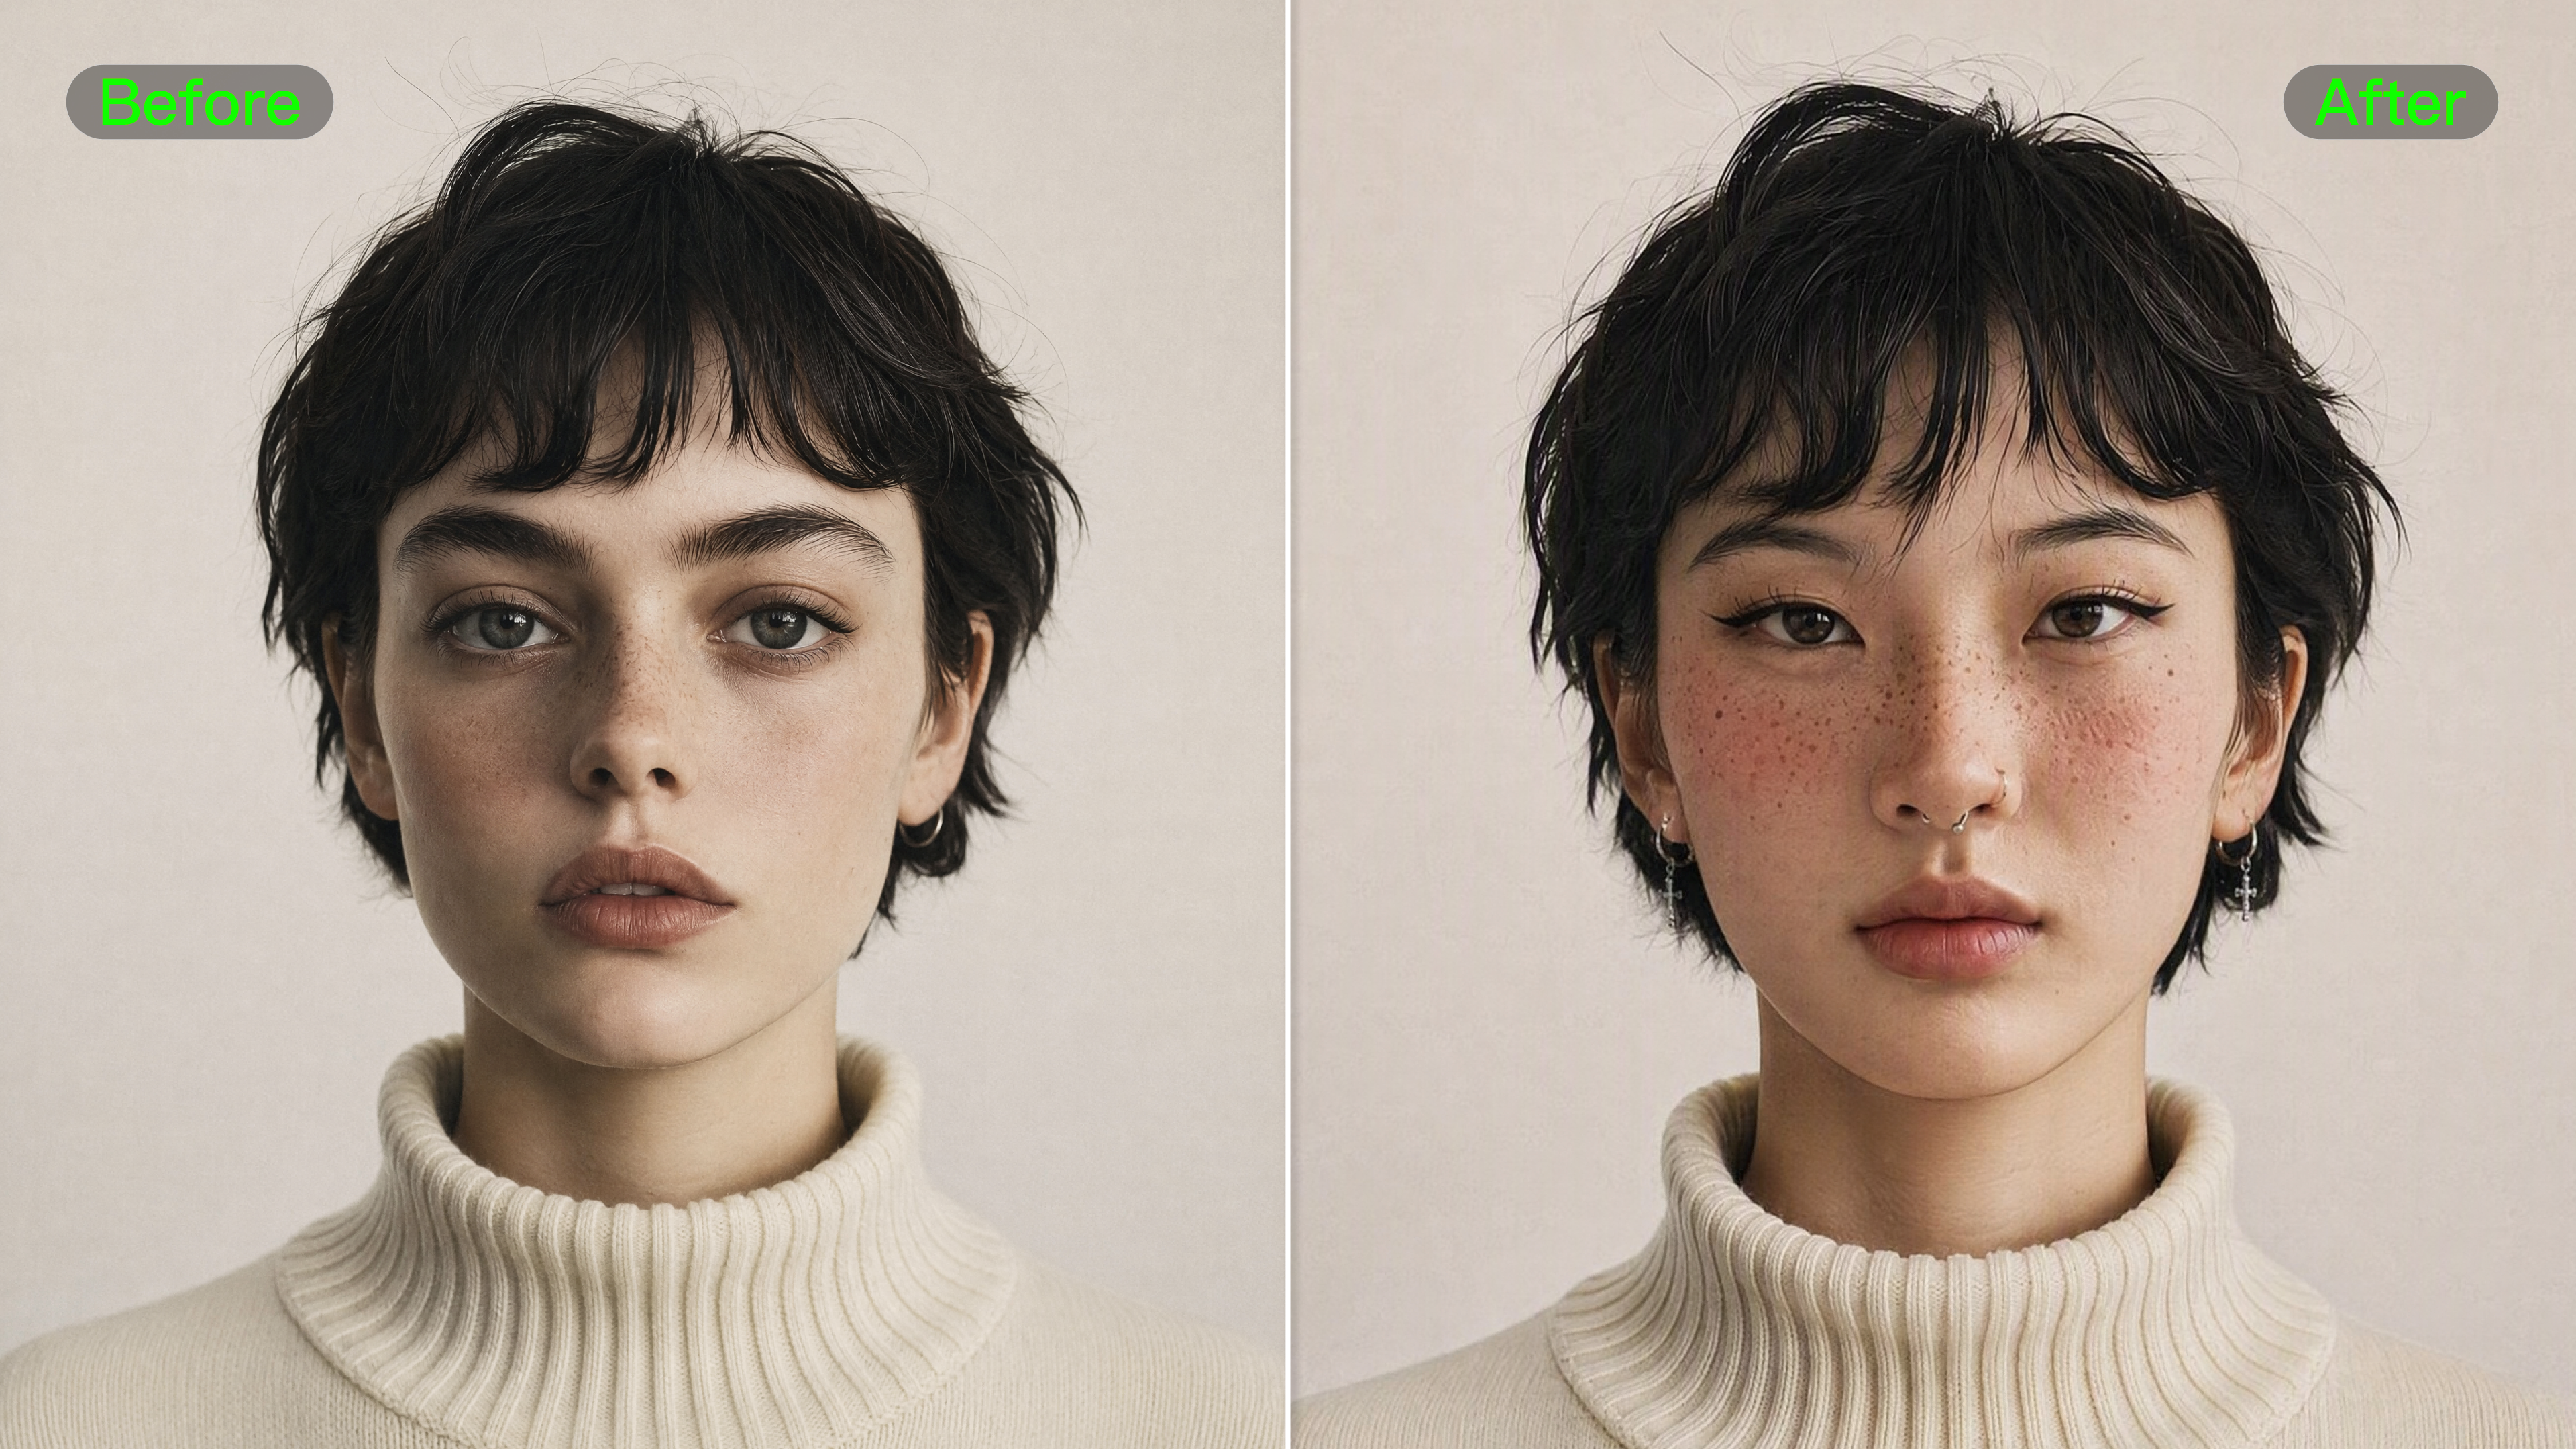
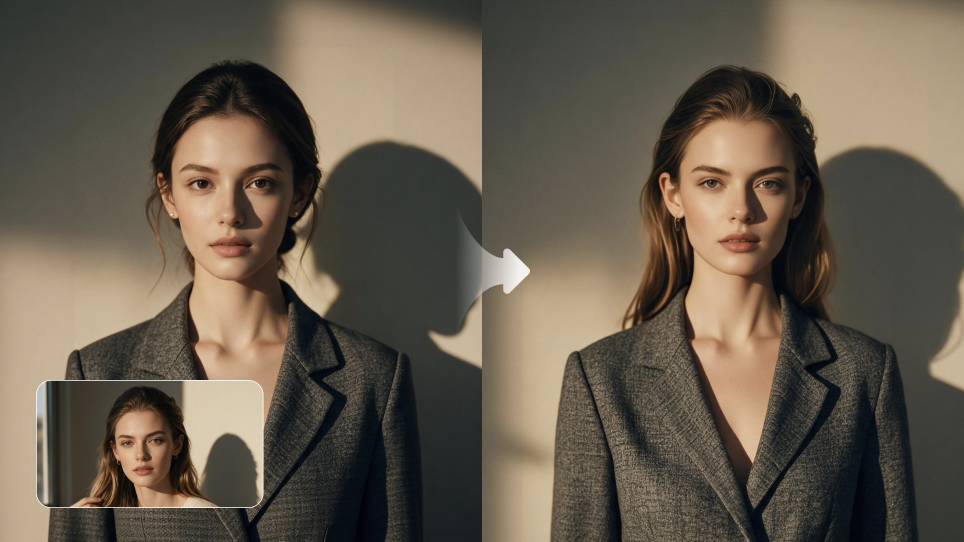
Se la maggior parte di un'immagine appare già come desideri, puoi utilizzare Kling IMAGE 3.0 come editor di foto basato su IA per regolare dettagli specifici senza ricostruire l'intera scena. I comandi in linguaggio naturale possono modificare la dimensione, il colore, il materiale, l'espressione o lo sfondo di un oggetto preservando al contempo le parti circostanti dell'immagine. Puoi anche usare Kling AI come strumento per rimuovere filigrane per le immagini che possiedi o che hai il permesso di modificare. Altri interventi includono la colorizzazione delle foto, effetti vintage, modifiche ai doodle, cambiamenti di illuminazione e di tonalità e il restauro delle immagini.
Mantieni stile e tono coerenti tra le immagini Se hai già una direzione visiva chiara, puoi usare un'immagine esistente come riferimento di stile. Kling IMAGE 3.0 può trasferire elementi come pennellate, colore, composizione e tono in nuove immagini. Questo funziona bene per serie di illustrazioni, visualizzazioni di prodotto o contenuti di brand in cui lo stesso look deve comparire in più immagini.
Immagine di riferimento 1 | Immagine di riferimento 2 | Immagine di output |
Prompt: Cambia lo stile dell'Immagine 1 con quello dell'Immagine 2 | ||
Fine
I modelli di testo in immagine differiscono per ciò che sanno fare meglio, quindi la scelta giusta dipende da quello di cui hai bisogno dopo la generazione della prima immagine. Se ti serve solo un concept rapido, la precisione del prompt e la qualità dell'immagine possono essere sufficienti. Per visual per prodotti, personaggi ricorrenti o serie di immagini, contano di più i riferimenti, l'editing e la coerenza. Se vuoi partire da testo o da visual esistenti, Kling IMAGE 3.0 ti permette di combinare riferimenti, modificare dettagli specifici e mantenere lo stesso look nelle nuove immagini. Che tu stia costruendo una campagna di prodotto, sviluppando un personaggio ricorrente o trasformando un concept iniziale in un set visual completo, il modello giusto dovrebbe semplificarti il mantenimento dei dettagli a cui tieni man mano che il progetto cresce.
Domande frequenti
Quale modello linguistico di IA viene utilizzato per la creazione text-to-image?
Nessun singolo modello linguistico viene utilizzato da tutti i sistemi da testo a immagine. Se ti stai chiedendo quale modello linguistico di IA venga impiegato per le funzionalità di creazione da testo a immagine, la risposta varia in base al modello. Alcuni sistemi utilizzano codificatori di testo come CLIP o T5, mentre altri impiegano componenti linguistici o di visione-linguaggio per leggere il prompt prima che l'immagine venga generata.
Quale IA può trasformare il testo in immagine?
Molti modelli di immagini IA possono trasformare un prompt scritto in un'immagine finita, tra cui Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 e Runway Gen-4 Image. Ognuno gestisce i prompt, i riferimenti, le modifiche e la coerenza visiva in modo diverso, quindi il modello giusto dipende dal tipo di immagine che devi creare.
I modelli da testo a immagine possono utilizzare immagini di riferimento?
Sì. Molti modelli text-to-image possono utilizzare immagini di riferimento insieme ai prompt scritti, il che rende image-to-image AI utile quando vuoi lavorare da un elemento visivo esistente invece di partire da zero. Il riferimento può stabilire dettagli come il personaggio, il prodotto, la posa, la composizione, i colori o lo stile, mentre il prompt indica al modello cosa cambiare. Kling IMAGE 3.0 può utilizzare fino a 10 immagini di riferimento in una singola generazione, il che è utile quando lo stesso personaggio, prodotto o stile visivo deve rimanere riconoscibile.
Come faccio a rimuovere lo sfondo da un'immagine?
Se hai bisogno di uno scatto del prodotto più pulito, di un'immagine del profilo o di una risorsa di design, puoi rimuovere lo sfondo da un'immagine e mantenere il soggetto principale isolato. Uno sfondo trasparente funziona bene per schede prodotto, presentazioni, post sui social o layout in cui il soggetto deve trovarsi su uno sfondo diverso. Dopo la rimozione, controlla i bordi sottili attorno a capelli, abiti, pelliccia o oggetti di piccole dimensioni, quindi mantieni lo sfondo trasparente, passa a un colore uniforme o colloca il soggetto in una nuova scena.