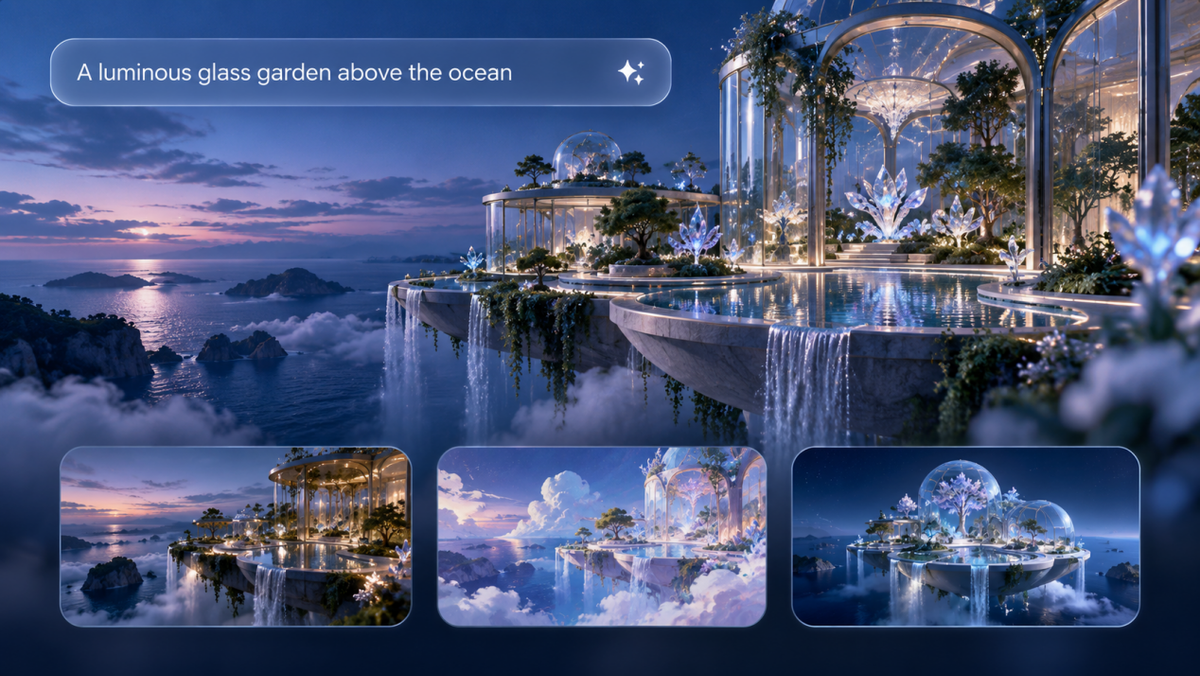
Маючи лише ідею або простий опис, моделі текст-у-зображення можуть перетворити природну мову на візуальні концепції. Для творців найкращі моделі текст-у-зображення виходять за межі генерації зображень. Вони мають розуміти складні промпти, зберігати візуальну узгодженість і підтримувати творче вдосконалення з часом. Цей посібник пояснює, як працюють моделі текст-у-зображення, порівнює найважливіші можливості та розглядає, як Kling IMAGE 3.0 поєднує створення на основі референсів, точне редагування й гнучкі робочі процеси, щоб допомогти творцям втілювати свої візуальні ідеї в життя.
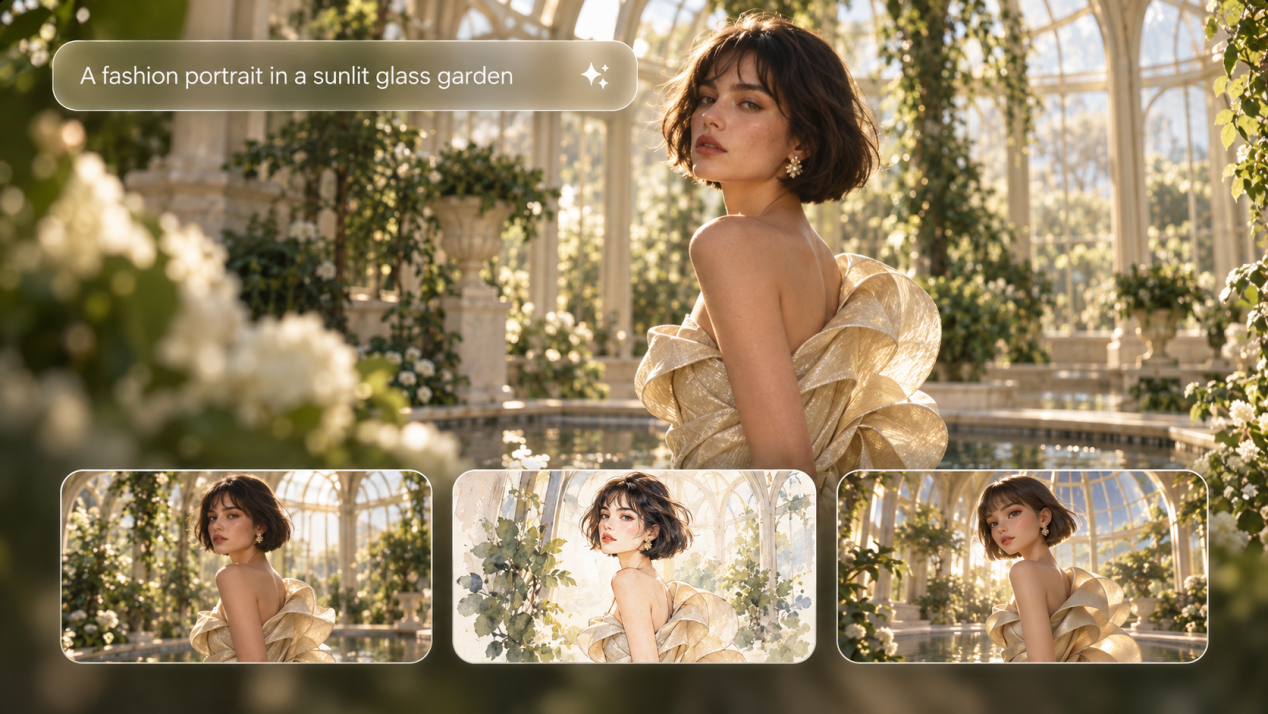
Що таке моделі текст-у-зображення?
Модель текст-у-зображення — це тип системи штучного інтелекту, яка перетворює запити природною мовою на цифрові зображення відповідно до деталей, описаних у запиті.
Сучасні системи текст-у-зображення зазвичай поєднують компонент, який розуміє або кодує промпт, з компонентом генерації зображень, що перетворює ці інструкції на візуальний контент. Деякі моделі також можуть працювати із зображеннями та іншими візуальними референсами, допомагаючи їм дотримуватися складних промптів, зберігати важливі деталі та підтримувати більш точне редагування.
Наприклад, розгляньмо промпт:
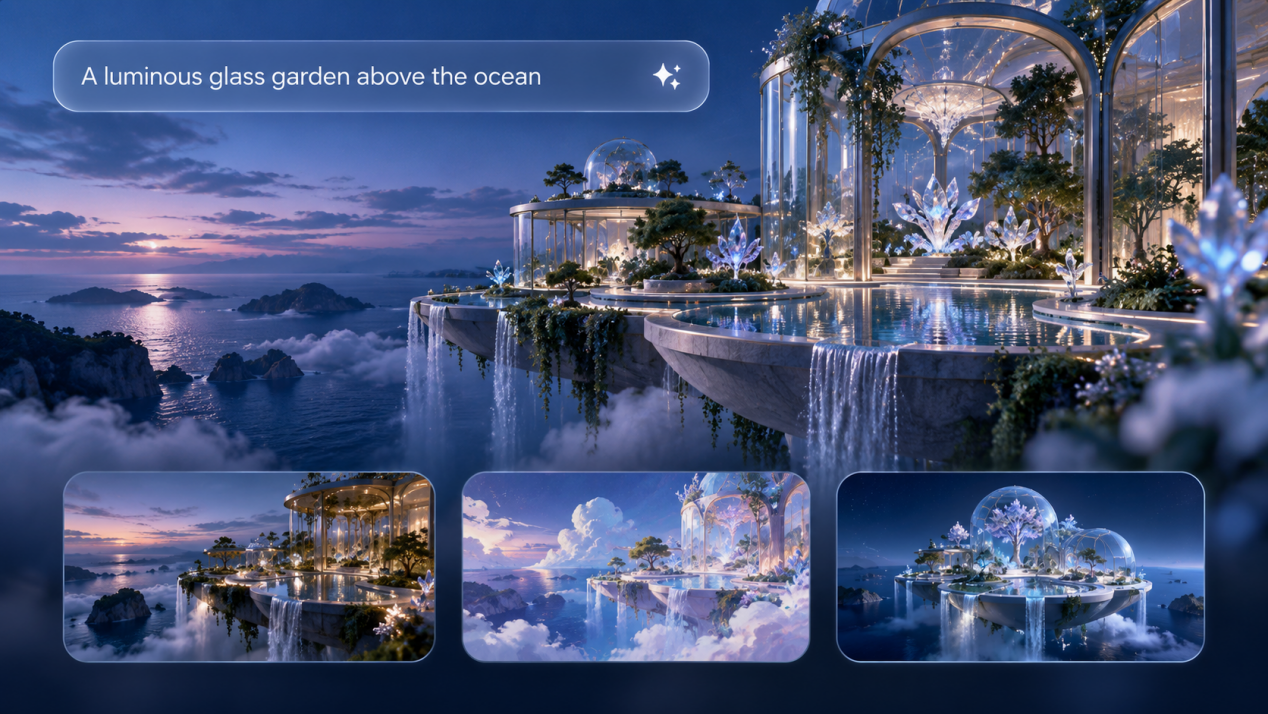
| Промпт: Вінтажна камера, розміщена на дерев'яному столі, на сцену падає м'яке ранкове світло. |
Модель повинна зрозуміти об'єкт, матеріал, просторове розташування, освітлення та загальний візуальний стиль, перш ніж створити відповідне зображення.
Сьогодні оцінювання моделей текст-у-зображення включає більше, ніж якість зображення. Акцент змістився на точне розуміння промптів, опрацювання складних сцен, підтримання візуальної послідовності та забезпечення гнучкого редагування.
Як працюють моделі текст-у-зображення?
Моделі перетворення тексту на зображення перекладають письмові описи у візуальний контент, навчаючись тому, як мова співвідноситься з об'єктами, стилями, композиціями та іншими деталями. Багато сучасних систем використовують методи на основі дифузії, причому підказка спрямовує покроковий процес, який поступово перетворює візуальний шум на готове зображення.
Процес можна уявити у трьох етапах:
1.Вивчення того, як текст пов'язаний із зображеннями
Перш ніж генерувати зображення, модель перетворення тексту на зображення навчається на великих наборах даних, що містять пари зображень і описів. Під час навчання вона визначає закономірності між словами та візуальними деталями, включно з об'єктами, кольорами, формами, стилями та просторовими взаємозв'язками. Наприклад, модель вчиться тому, як поняття на кшталт «вінтажна камера», «дерев'яний стіл» і «м'яке ранкове світло» асоціюються з конкретними візуальними характеристиками.
2.Розуміння підказки
Коли ви вводите підказку, система перекладає ваш текст у формат, який вона може зрозуміти, захоплюючи основний зміст і контекст. Хоча точна технологія різниться залежно від моделі — і комерційні системи часто тримають свою повну архітектуру в таємниці — ці текстові та візуальні компоненти працюють разом, щоб з’єднати ваші слова з кінцевим візуальним результатом.
3. Генерування зображення
Багато сучасних моделей перетворення тексту на зображення використовують дифузійні методи, хоча інші моделі можуть застосовувати авторегресивні чи інші підходи до генерації. У системах на основі дифузії процес починається з візуального шуму й поступово усуває цей шум на основі інформації, наданої підказкою. Через повторювані кроки усунення шуму зображення набуває чіткіших форм, деталей і стилів, що відповідають опису. Деякі системи виконують цей процес у стисненому латентному просторі, перш ніж перетворити результат у фінальне зображення. Після формування зображення можна внести додаткові коригування, щоб уточнити деталі або підготувати його до редагування.
Що відрізняє моделі текст-у-зображення?
Моделі текст-у-зображення можуть реагувати дуже по-різному на один і той самий запит. Частково це залежить від способу генерації зображень, а частково — від типів вхідних даних, які модель здатна читати й використовувати.
Архітектура генерації
На рівні генерації поширені два підходи: дифузійний та авторегресійний.
Підхід | Як це працює | Поширені варіанти використання |
Дифузійні моделі | Почніть із візуального шуму й поступово перетворюйте його на зображення, керуючись підказкою. | Детальна генерація зображень, реалістичні сцени, ілюстрації та робота, орієнтована на стиль. |
Авторегресивні моделі | Створюйте зображення, послідовно передбачаючи візуальні токени або елементи. | Генерація зображень, яка створює візуальний контент послідовно, замість уточнення шуму. |
Дифузійні моделі залишаються активною сферою досліджень текст-у-зображення. Огляд 2023 року Text-to-image Diffusion Models in Generative AI: A Survey надає корисний огляд методів текст-у-зображення на основі дифузії, наборів даних, підходів до оцінювання та пов'язаних застосувань.
Мультимодальні вхідні дані
Термін «мультимодальний» описує типи вхідних даних, які може використовувати модель, а не спосіб генерації зображення. Мультимодальна модель зображень може приймати текст, зображення та візуальні референси для створення на основі прикладів, редагування або підтримання узгодженості персонажів і продуктів у серії. В основі вона все ще може використовувати дифузію, авторегресивну генерацію чи інший метод, тож модель може належати до більше ніж однієї категорії.
Які найкращі моделі текст-у-зображення у 2026 році?
Для цього посібника ми відібрали сім актуальних моделей, що представляють різні підходи до створення зображень, редагування, референсної генерації та візуального продакшену. Порядок не є рейтингом.
Модель | Тип моделі | Найкраще підходить для | Ключові можливості |
Модель для створення та редагування зображень із мультимодальними вхідними даними | Створення на основі референсів, візуалізації продуктів, персонажі та детальне редагування | Генерує на основі тексту або зображень, поєднує характеристики до 10 референсів і підтримує збереження обʼєкта, точні редагування та контроль стилю. IMAGE 3.0 підтримує генерацію до 2K, тоді як IMAGE 3.0 Omni пропонує до 4K. | |
Leonardo Lucid Origin | Модель для генерації зображень | Ілюстрації, концепт-арт, макети продуктів і загальне створення зображень | Охоплює широкий спектр стилів, слідує докладним підказкам, створює зображення у Full HD та підтримує читабельне відтворення тексту. |
Seedream 5.0 Pro | Модель для генерування та редагування зображень | Продуктові зображення, інфографіка, дизайнерські ресурси та локальні правки | Працює з текстом або зображеннями, приймає референси, підтримує регіональне редагування та обробляє багатомовне введення й генерацію. |
Adobe Firefly Image 5 | Модель генерування та редагування зображень | Виробництво дизайну, маркетингові активи та проєкти на базі Adobe | Генерує з тексту, працює з референсними зображеннями та дозволяє виконувати точкові правки у Photoshop, зберігаючи навколишній вміст зображення недоторканим. |
Krea 2 Large | Модель генерування зображень | Фотореалізм, робота, орієнтована на стиль, та візуальне спрямування | Оптимізовано для виразного фотореалізму, з генерацією за підказками та керуванням композицією, об'єктом і стилем, яке здійснюється на основі референсів. |
Luma UNI-1.1 | Уніфікована мультимодальна модель зображень | Генерація та редагування зображень, що керуються референсами | Поєднує генерацію зображень із редагуванням природною мовою та приймає до дев'яти референсів в одному запиті. |
Runway Gen-4 Image | Модель генерації зображень у межах платформи для зображень і відео | Розробка персонажів, дизайн сцен і проєкти, які згодом переходять у відео | Генерує за текстом і референсними зображеннями, використовує до трьох референсів за одну генерацію та може переносити персонажів, об'єкти або візуальні риси в нові сцени. |
Наступний розділ порівнює ці моделі за точністю виконання підказок, роботою з референсами, редагуванням, візуальною узгодженістю та контролем стилю.
Як порівнюються моделі текст-у-зображення у 2026 році?
Моделі текст-у-зображення найбільше відрізняються точністю виконання підказок, використанням референсів, редагуванням, узгодженістю та контролем стилю. Ці відмінності легше помітити у проєктах, що передбачають повторювані зображення, правки, продукти або повторюваних персонажів.
Область порівняння | Що порівнювати | Чому це важливо |
Дотримання промпту | Об'єкти, атрибути, взаємозв'язки між об'єктами, композиція та необхідні подробиці. | Навіть бездоганно відшліфоване зображення все одно не виправдовує очікувань, якщо воно не відповідає брифу. |
Обробка референсів | Кількість референсів, збереження об'єкта, передача стилю та керування композицією. | Референси допомагають зберігати впізнаваність персонажа, продукту або візуального напряму в різних зображеннях. |
Редагування зображень | Локальні зміни, редагування природною мовою та наскільки добре недоторкані області залишаються незмінними. | Точні правки заощаджують час і дозволяють уникнути відтворення зображення з нуля. |
Візуальна узгодженість | Персонажі, продукти, одяг, стиль і повторювані деталі в різних зображеннях або версіях. | Стабільні деталі важливі для серій зображень, кампаній, сторібордів і продуктових наборів. |
Контроль стилю | Освітлення, палітра, текстура, фотографічний вигляд, стиль ілюстрації та візуальна спрямованість. | Чіткий контроль стилю допомагає зберігати візуальний зв'язок між пов'язаними зображеннями. |
Відповідність робочому процесу | Правки, параметри експорту, використання зображень для відео та сумісність з іншими інструментами для творчості. | Те, що відбувається після генерації, може бути не менш важливим, ніж перше зображення. |
Модель, що добре підходить для швидких концептуальних зображень, може не підійти для серії продуктів чи проєкту персонажа. Точності промптів і стилю може бути достатньо для одного зображення, тоді як повторювана робота часто потребує надійніших референсів, редагування та послідовності.
Як обрати найкращу модель текст-у-зображення?
Під час вибору генератора зображень ШІ, почніть з того, що саме ви хочете створити і які деталі повинні залишатися незмінними під час редагування зображення. Таблиця нижче показує, на що звертати увагу в кількох поширених сценаріях.
Якщо вам потрібно | Шукайте | Чому це важливо |
Швидкі концептуальні зображення | Точність запиту, якість зображення та діапазон стилів | Ви можете наблизитися до бажаного результату з меншою кількістю правок. |
Послідовні персонажі або продукти | Робота з референсами та збереження деталей | Обличчя, одяг, продукти та інші визначальні риси повинні залишатися впізнаваними на всіх зображеннях. |
Часті правки зображень | Локальне редагування та зміни за допомогою природної мови. | Ви можете коригувати одну частину зображення, не перебудовуючи всю сцену. |
Ресурси кампанії або серії зображень | Стабільні об'єкти, стиль і композиція | Пов'язані зображення повинні дотримуватися одного візуального напряму. |
Зображення, які згодом переходять у відео | Референсні зображення та опції перетворення зображення у відео | Стабільні об'єкти та візуальні деталі легше перенести в рух. |
Чому варто розглянути Kling IMAGE 3.0?
Kling IMAGE 3.0 дозволяє розпочинати створення з текстового запиту або референсних зображень, а потім тонко налаштовувати кожну деталь за допомогою природної мови. Поза межами стандартної генерації вона надає глибокий контроль над узгодженістю персонажів, точними правками та налаштуванням стилю, відкриваючи безмежні творчі можливості.
Перетворюйте складні ідеї на нові візуальні образи
IMAGE 3.0 дозволяє змішувати візуальні підказки з кількох референсів і використовувати повсякденну мову, щоб виходити за межі стандартних правок. Поєднуйте об'єкти між зображеннями, змінюйте перспективу сцени або переносьте концепцію в абсолютно новий стиль — і все це зберігаючи підсумковий результат безшовним і цілісним.
Референсне зображення 1 | Референсне зображення 2 | Вихідне зображення |
Запит: Об'єднайте тварин із зображень 1 і 2. | ||
Зберігайте впізнаваність персонажів, продуктів та ключових деталей
Ви можете використовувати до 10 референсних зображень в одній генерації. Різні референси можуть визначати персонажа, одяг, продукт, оточення або стиль, тоді як ваш запит пояснює, як ці елементи мають поєднуватися. Для ретуші портретів референси обличчя допомагають зберегти впізнавані риси, поки ви змінюєте зачіску, вбрання, позу або оточення. Якщо ви просто хочете підставити інше обличчя в наявний кадр, ви також можете відразу перейти до заміни обличчя робочих процесів Kling.
Змінюйте лише те, що потрібно змінити
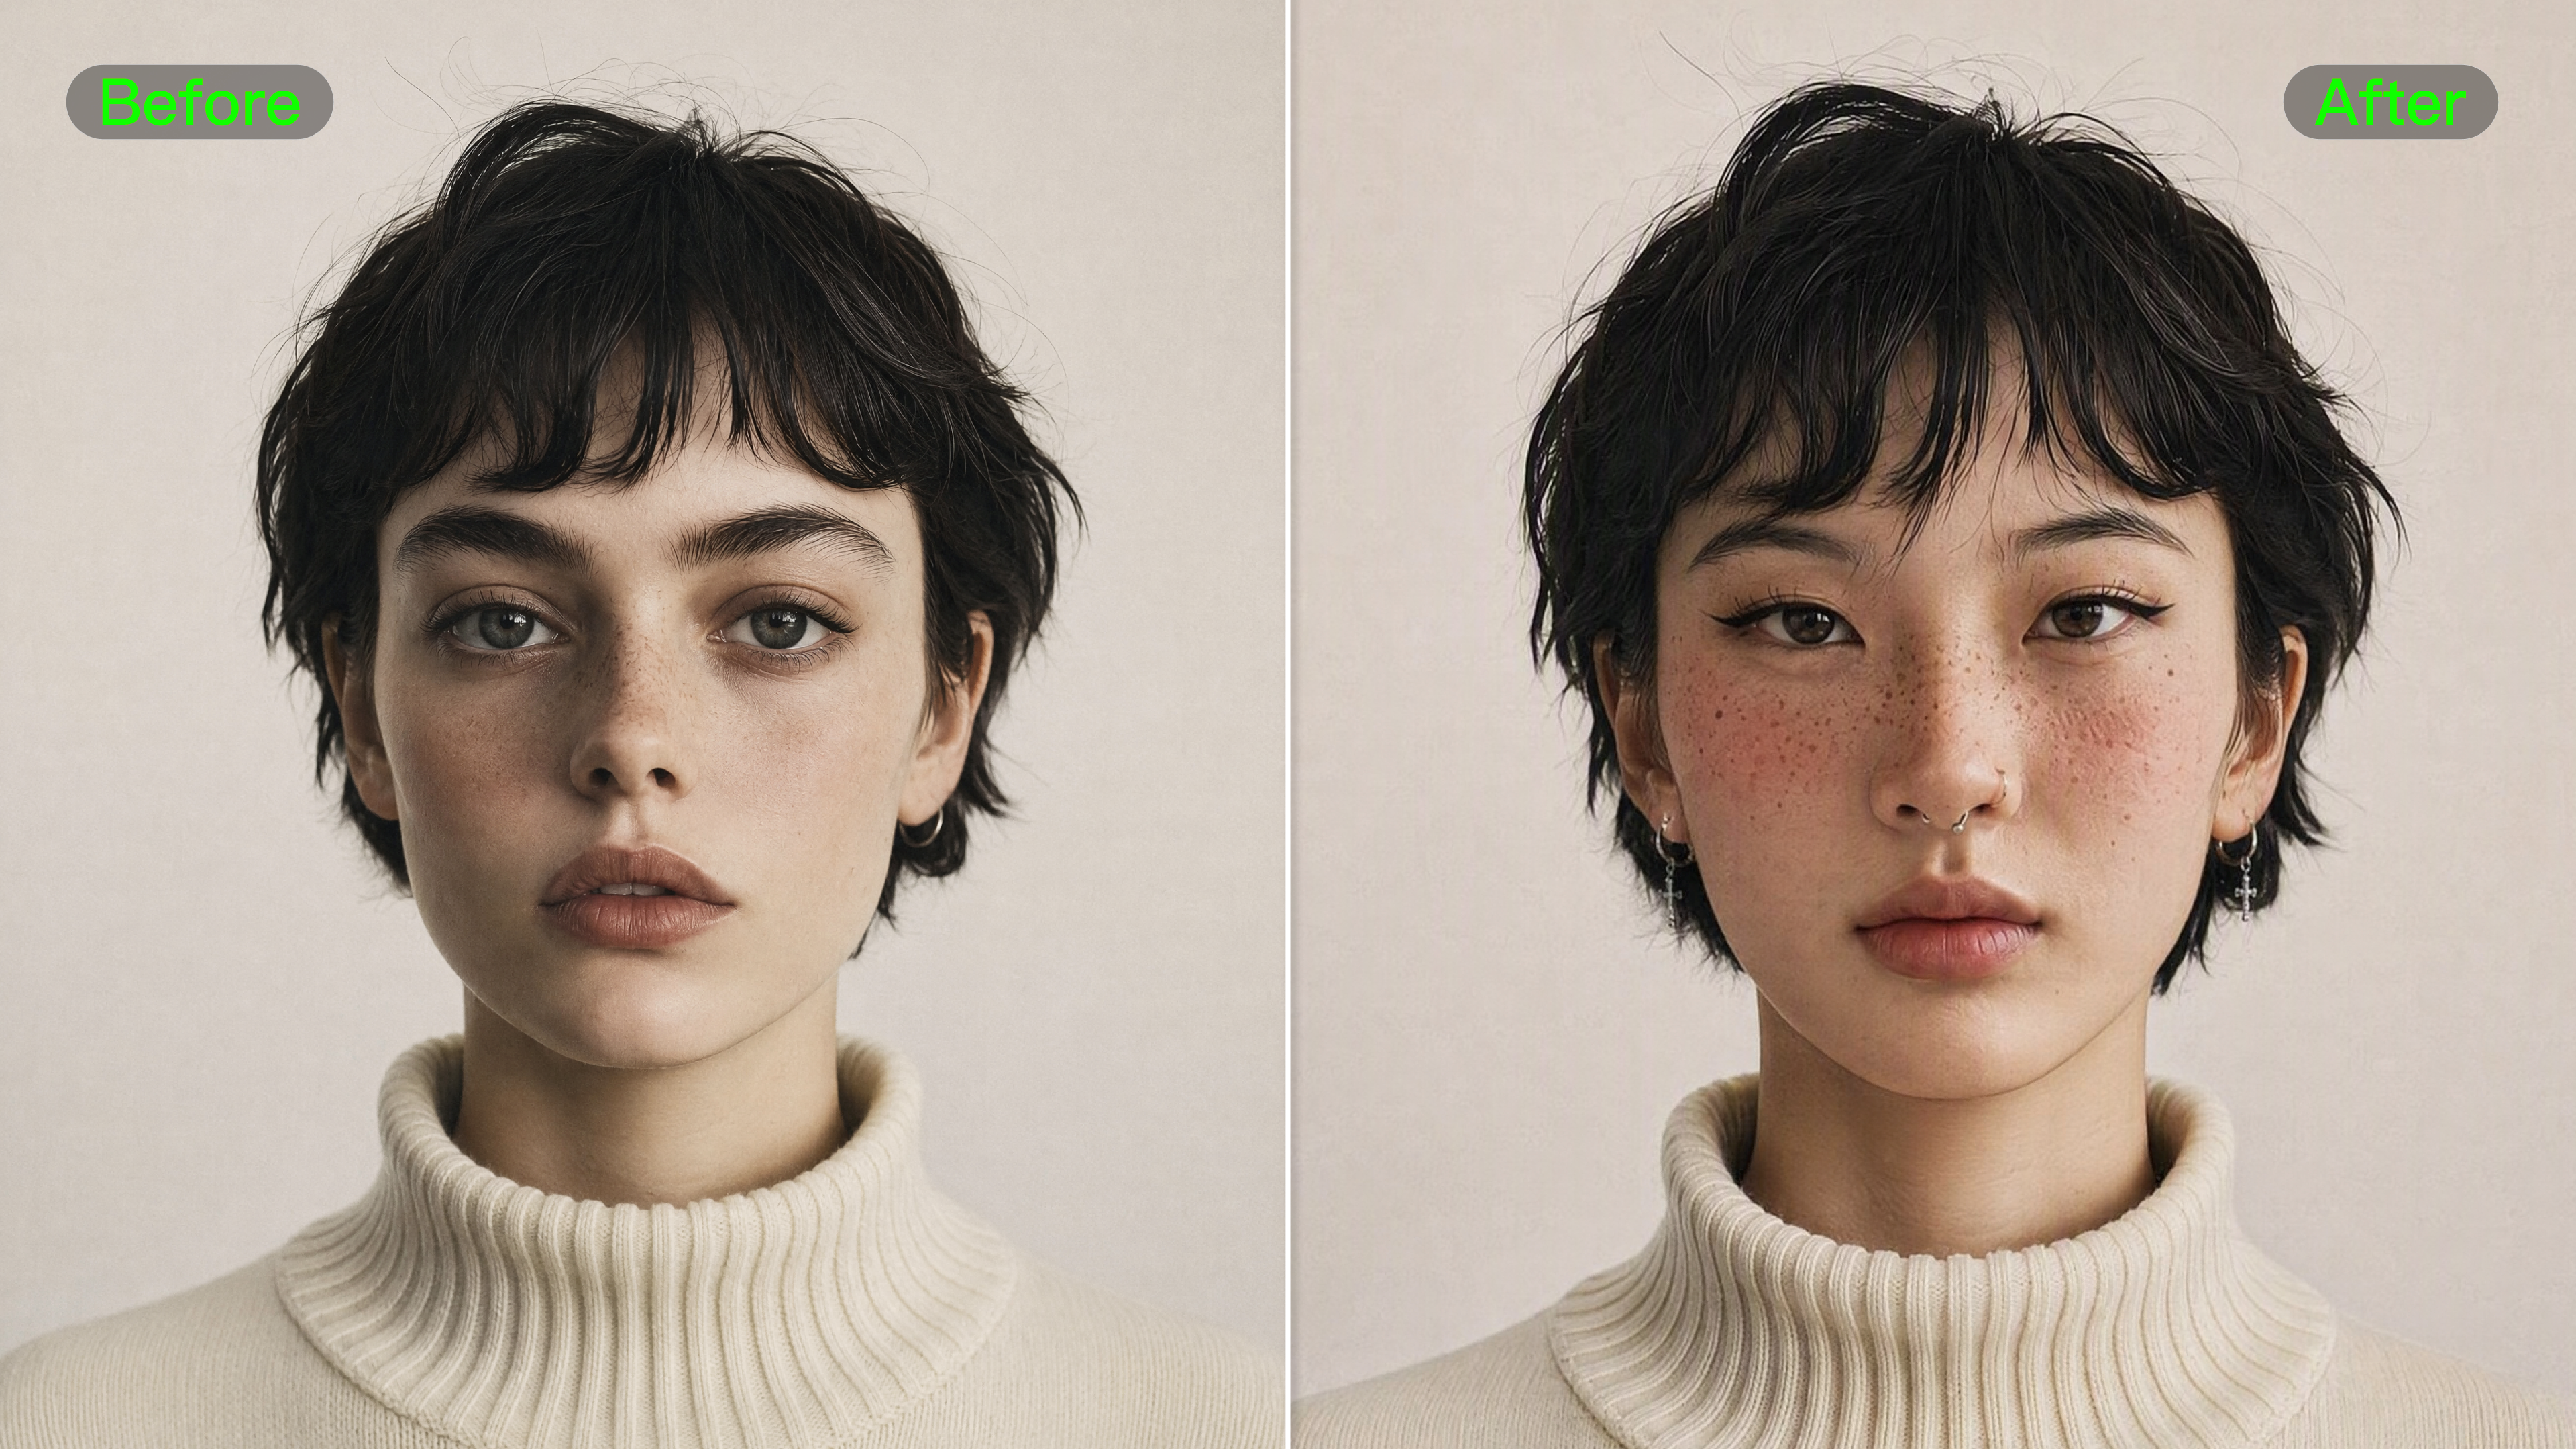
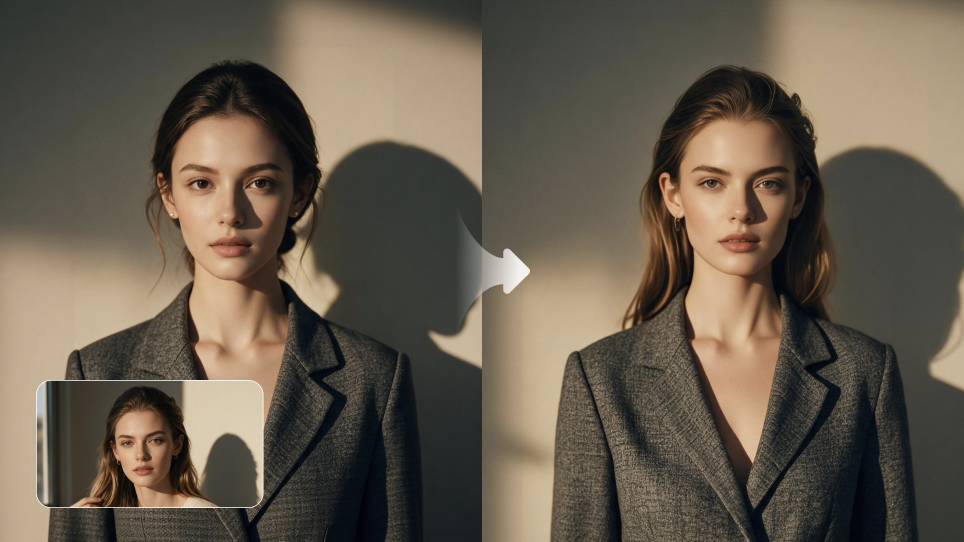
Якщо більша частина зображення вже виглядає правильно, ви можете використати Kling IMAGE 3.0 як редактор фотографій на основі ШІ, щоб скоригувати окремі деталі без необхідності відтворювати всю сцену заново. Команди природною мовою можуть змінити розмір, колір, матеріал, вираз або фон об'єкта, водночас зберігаючи навколишні частини зображення. Ви також можете використовувати Kling AI як засіб для видалення водяних знаків для зображень, які вам належать або які ви маєте право редагувати. Інші можливі зміни включають розфарбовування фотографій, вінтажні ефекти, редагування начерків, коригування освітлення та тону, а також відновлення зображень.
Зберігайте стиль і тон узгодженими в усіх зображеннях Якщо у вас вже є чітке візуальне бачення, ви можете використати наявне зображення як еталон стилю. Kling IMAGE 3.0 може переносити такі елементи, як манера мазків, колір, композиція та тон, у нові зображення. Це добре працює для наборів ілюстрацій, візуалів продуктів або брендового контенту, де однаковий вигляд має з'являтися на більш ніж одному зображенні.
Референтне зображення 1 | Референтне зображення 2 | Вихідне зображення |
Підказка: Змініть стиль Зображення 1 на стиль Зображення 2 | ||
Кінець
Моделі «текст у зображення» відрізняються тим, із чим справляються найкраще, тож правильний вибір залежить від того, що вам потрібно після створення першого зображення. Якщо вам потрібна лише швидка концепція, точність підказки та якість зображення можуть бути достатніми. Для продуктових візуалів, повторюваних персонажів або серій зображень більшу роль відіграють референси, редагування та послідовність. Якщо ви хочете почати з тексту або наявних візуалів, Kling IMAGE 3.0 дає змогу поєднувати референси, змінювати конкретні деталі та переносити той самий вигляд у нові зображення. Незалежно від того, чи створюєте ви продуктову кампанію, розробляєте повторюваного персонажа або перетворюєте ранню концепцію на завершений візуальний набір, правильна модель повинна полегшувати збереження важливих для вас деталей у міру зростання проєкту.
Поширені запитання
Яку мовну модель ШІ використовують для створення з тексту в зображення?
Жодна єдина мовна модель не використовується кожною системою текст-у-зображення. Якщо ви запитуєте, яка мовна модель ШІ використовується для можливостей створення зображень з тексту, відповідь відрізняється залежно від моделі. Деякі системи використовують текстові енкодери, наприклад CLIP або T5, тоді як інші застосовують мовні чи мовно-візуальні компоненти, щоб прочитати підказку перед генерацією зображення.
Який ШІ може перетворити текст на зображення?
Багато моделей ШІ для зображень можуть перетворити письмовий промпт на готове зображення, зокрема Kling IMAGE 3.0, Leonardo Lucid Origin, Seedream 5.0 Pro, Adobe Firefly Image 5, Krea 2 Large, Luma UNI-1.1 та Runway Gen-4 Image. Кожна по-різному працює з промптами, референсами, редагуваннями та візуальною узгодженістю, тож відповідна модель залежить від того, яке зображення вам потрібно створити.
Чи можуть моделі текст-у-зображення використовувати референсні зображення?
Так. Багато моделей «текст-у-зображення» можуть використовувати опорні зображення разом із письмовими підказками, що робить ШІ для перетворення зображення в зображення корисним, коли ви хочете працювати з наявним візуалом, а не починати з нуля. Опорне зображення може визначати такі деталі, як персонаж, продукт, поза, композиція, кольори або стиль, тоді як підказка повідомляє моделі, що змінювати. Kling IMAGE 3.0 може використовувати до 10 опорних зображень під час одного генерування, що зручно, коли той самий персонаж, продукт або візуальний стиль має залишатися впізнаваним.
Як видалити фон із зображення?
Якщо вам потрібен чистіший знімок продукту, фотографія профілю або дизайнерський ресурс, ви можете видалити фон із зображення і залишити головний об’єкт ізольованим. Прозоре тло добре підходить для списків товарів, презентацій, публікацій у соцмережах або макетів, де об’єкт має розміщуватися на іншому тлі. Після видалення перевірте тонкі краї навколо волосся, одягу, хутра чи дрібних об’єктів, а потім залиште тло прозорим, замініть його на суцільний колір або розмістіть об’єкт у новій сцені.